Linear Discriminant Analysis

Today

  • Bayes’ theorem
  • LDA, one feature and several
  • Comparison with logistic regression

Motivation

Credit card default data

ISLR2::Default · analyzed in the logistic regression lectures

Default Customers Proportion Mean balance ($) SD of balance ($) Zero balances
No 9,667 0.9667 804 456 499
Yes 333 0.0333 1,748 341 0

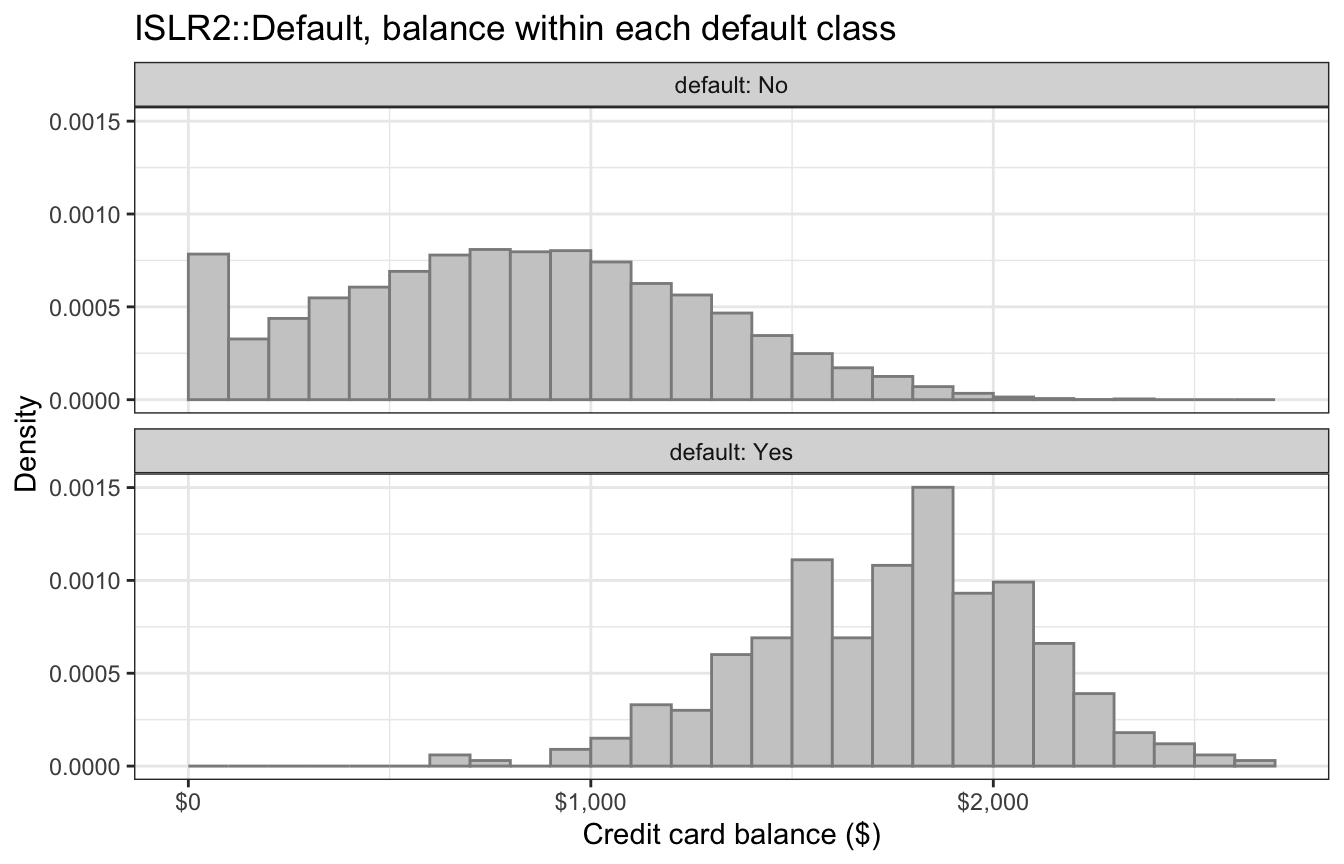
Balance within each class

Defaulters carry larger balances

Balance, all customers
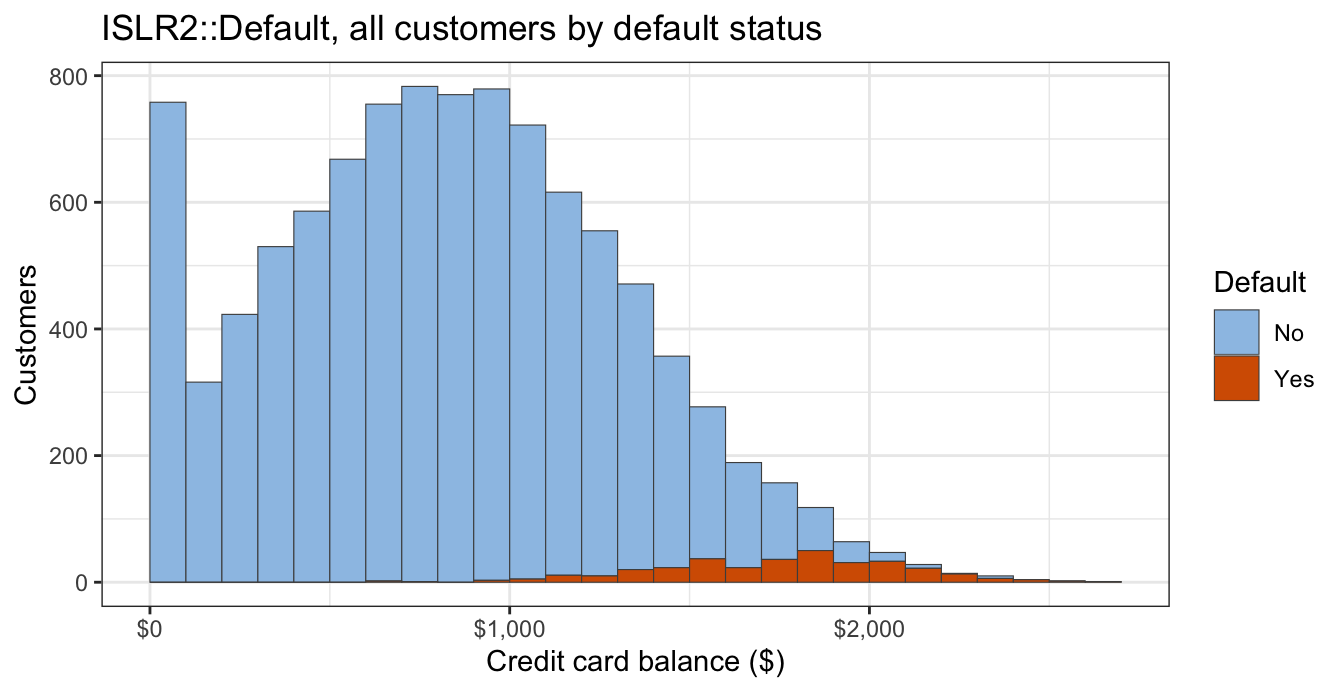
Stacked counts: each class’s share of a bar is its share of customers

Bayes’ theorem and Bayes classifier

\[p_k(x) = P(Y = k \mid X = x) = \frac{\pi_k f_k(x)}{\sum_{l=1}^K \pi_l f_l(x)} \propto \pi_k f_k(x)\]

  • \(\pi_k\) — prior
  • \(f_k(x)\) — class density
  • \(p_k(x)\) — posterior

\[\widehat y(x) = \arg\max_k\, p_k(x)\]

One Feature

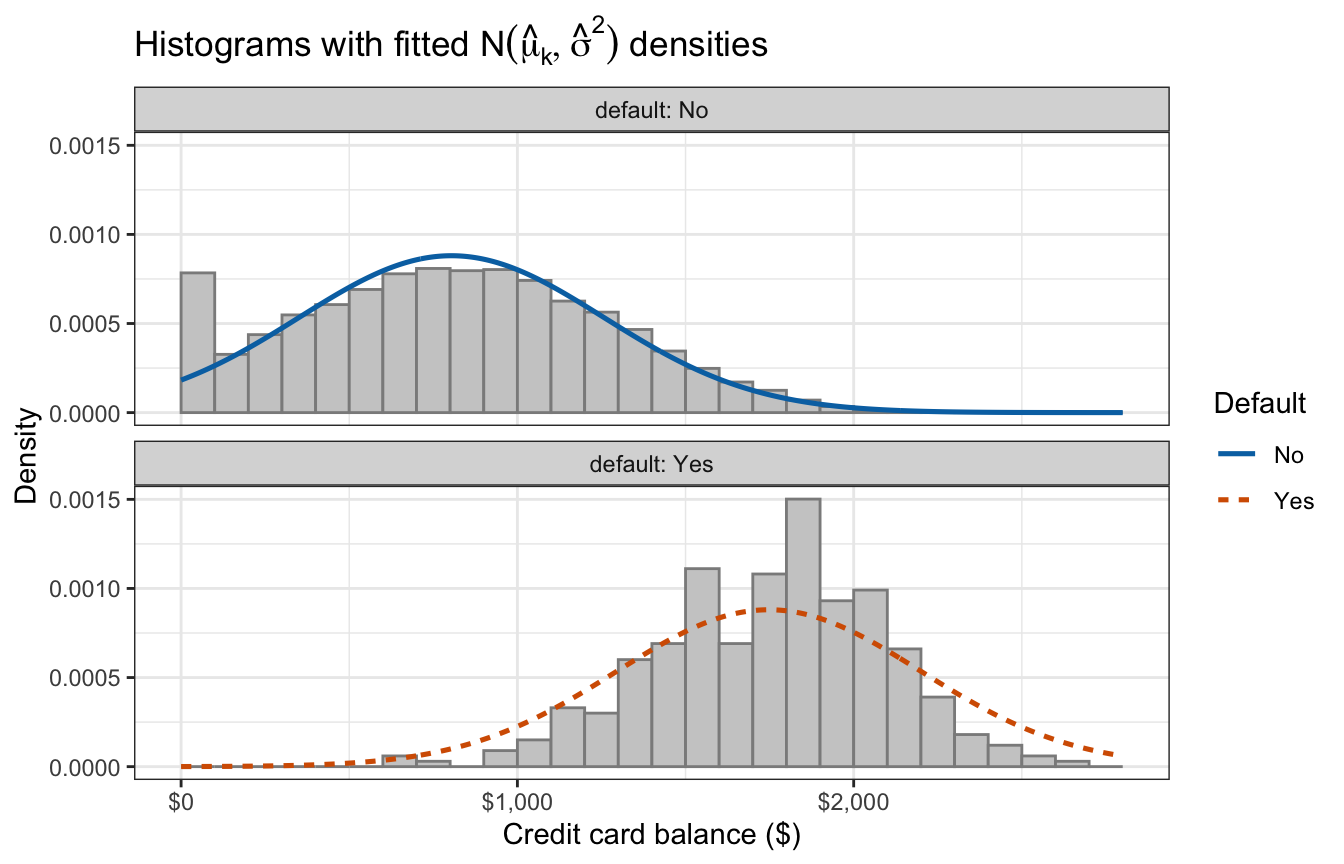
Fitted Gaussian densities

One-feature LDA: Gaussian densities fitted to each class

Gaussian model and parameter estimation

\[Y_i \stackrel{ind}{\sim} \text{Categorical}\left(\pi_1, \ldots, \pi_K\right), \qquad X_i \mid Y_i = k \stackrel{ind}{\sim} N\left(\mu_k, \sigma^2\right), \qquad i = 1, \ldots, n\]

Same \(\sigma^2\) in every class

\[\widehat\pi_k = \frac{n_k}{n}, \qquad \widehat\mu_k = \frac{1}{n_k}\sum_{i:\, y_i = k} x_i, \qquad \widehat\sigma^2 = \frac{1}{n - K}\sum_{k=1}^K \sum_{i:\, y_i = k}\left(x_i - \widehat\mu_k\right)^2\]

Closed-form estimates: proportions, means, pooled variance

Discriminant function

\[\log\left[\pi_k f_k(x)\right] = \log \pi_k - \frac{\mu_k^2}{2\sigma^2} + \frac{\mu_k}{\sigma^2}\, x - \log\left(\sqrt{2\pi}\,\sigma\right) - \frac{x^2}{2\sigma^2}\]

Dropping the terms that do not involve \(k\) gives the discriminant function

\[\delta_k(x) = \left(\log \pi_k - \frac{\mu_k^2}{2\sigma^2}\right) + \frac{\mu_k}{\sigma^2}\, x\]

Linear in \(x\)

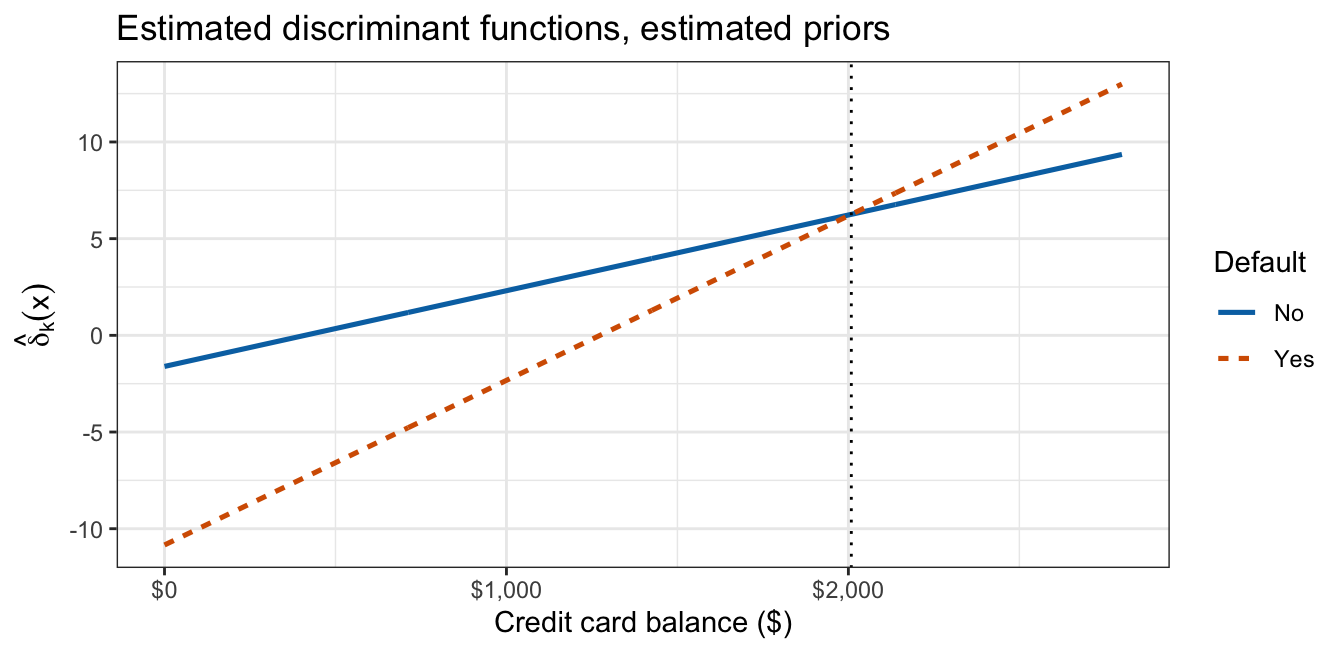
Decision boundary: where the two discriminants are equal, \(\delta_1(x) = \delta_2(x)\)

\[\log\left[\frac{p_2(x)}{1 - p_2(x)}\right] = \delta_2(x) - \delta_1(x) = \underbrace{\log\frac{\pi_2}{\pi_1} - \frac{\mu_2^2 - \mu_1^2}{2\sigma^2}}_{\beta_0} + \underbrace{\frac{\mu_2 - \mu_1}{\sigma^2}}_{\beta_1}\, x\]

\[x^* = \frac{\mu_1 + \mu_2}{2} + \frac{\sigma^2}{\mu_2 - \mu_1}\log\frac{\pi_1}{\pi_2}\]

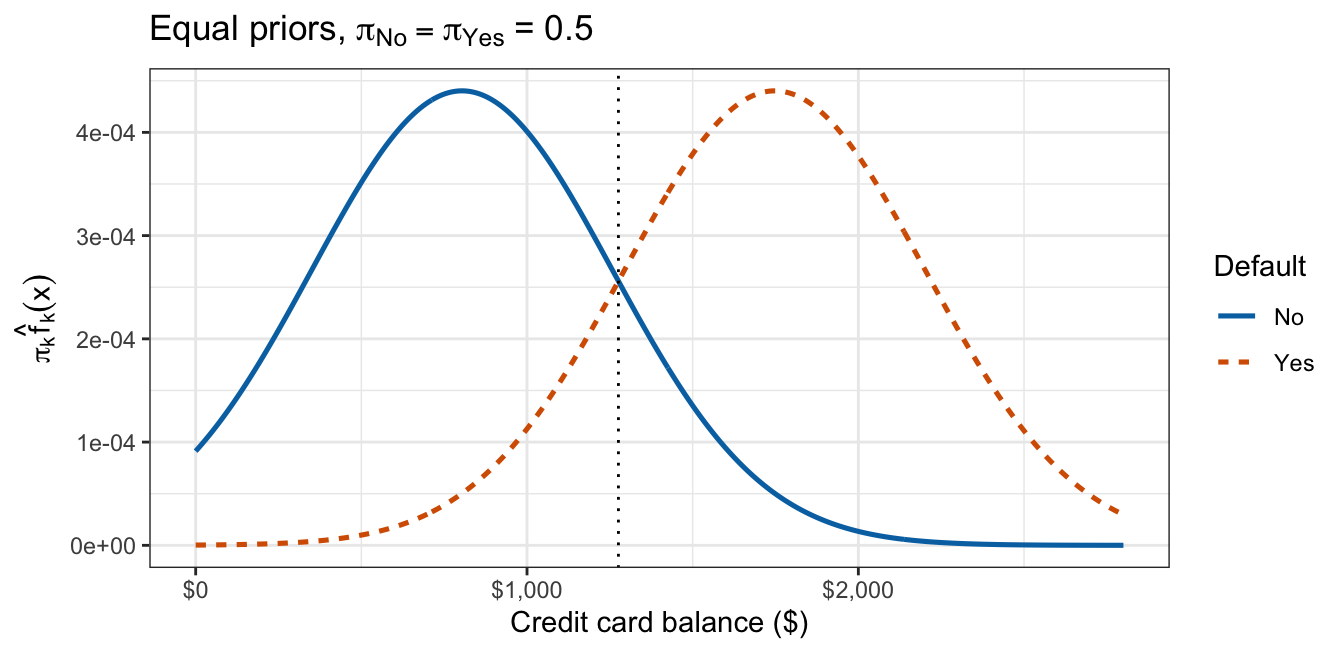
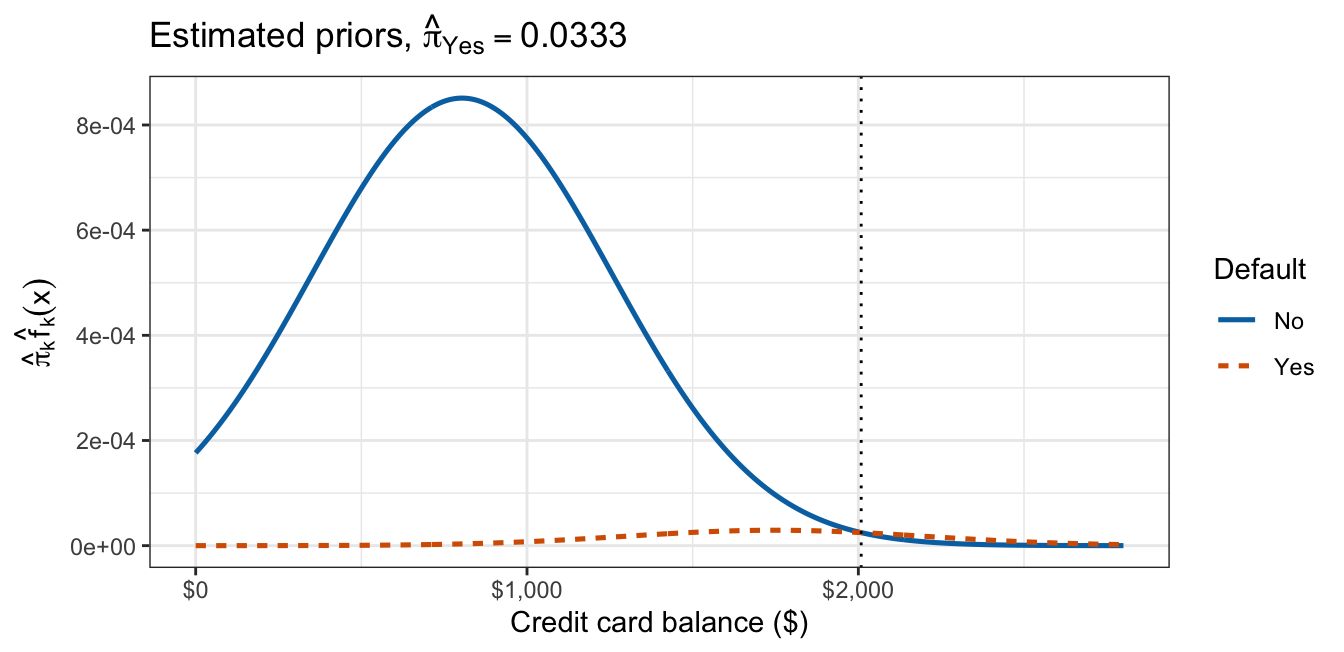
Prior-weighted densities

Equal priors put the boundary at the midpoint; the small prior for Yes moves it toward the defaulters’ mean
Fitting one-feature LDA

library("ISLR2")
fit <- MASS::lda(default ~ balance,
                 data = Default)

fit$prior     # pi-hat_k
fit$means     # mu-hat_k
fit$scaling   # coefficients of
              # linear discriminants

predict(fit,
        data.frame(balance = 1500)
       )$posterior
> fit$prior
    No    Yes 
0.9667 0.0333 

> fit$means
      balance
No   803.9438
Yes 1747.8217

> fit$scaling
                LD1
balance 0.002206916

> predict(...)$posterior
         No       Yes
1 0.9119783 0.0880217

Multiple Features

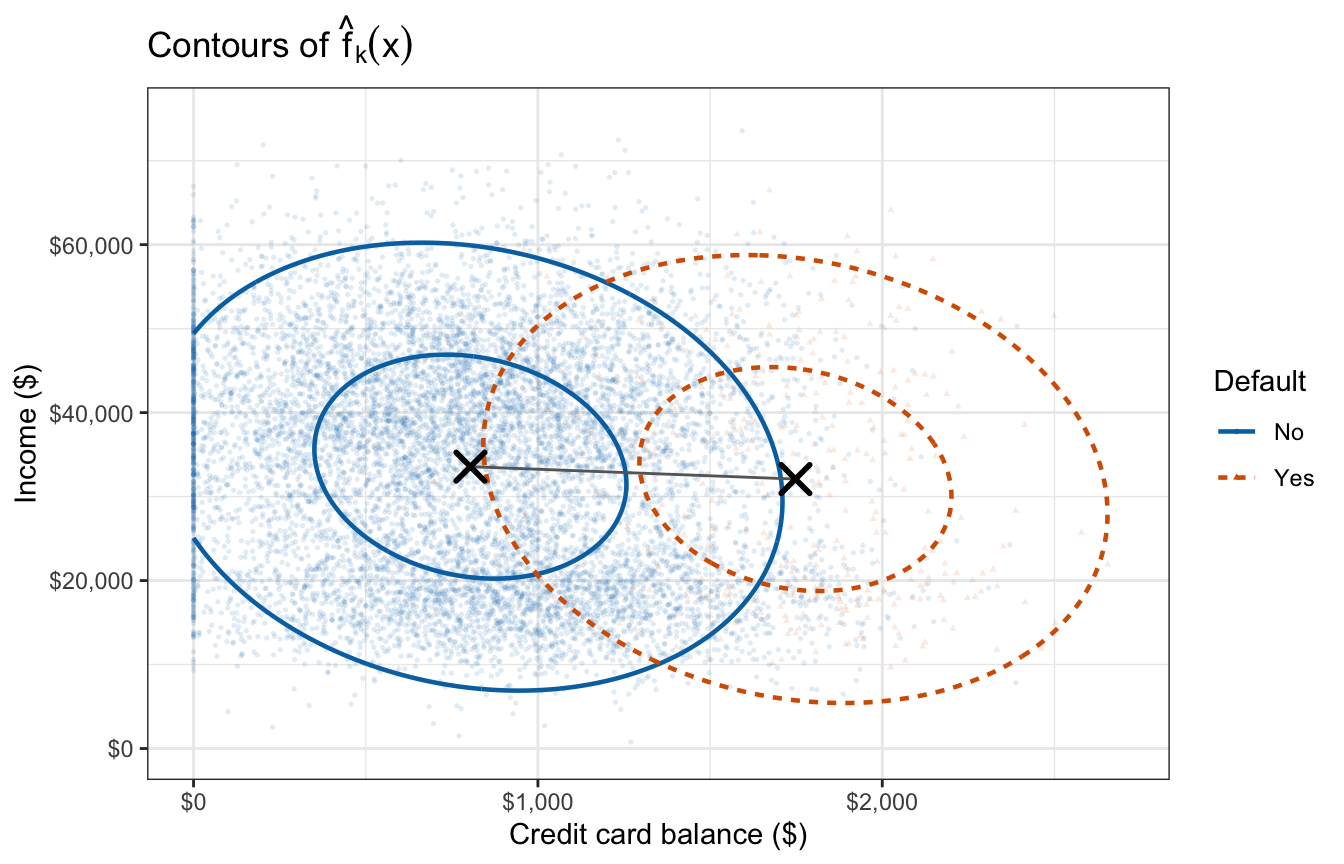
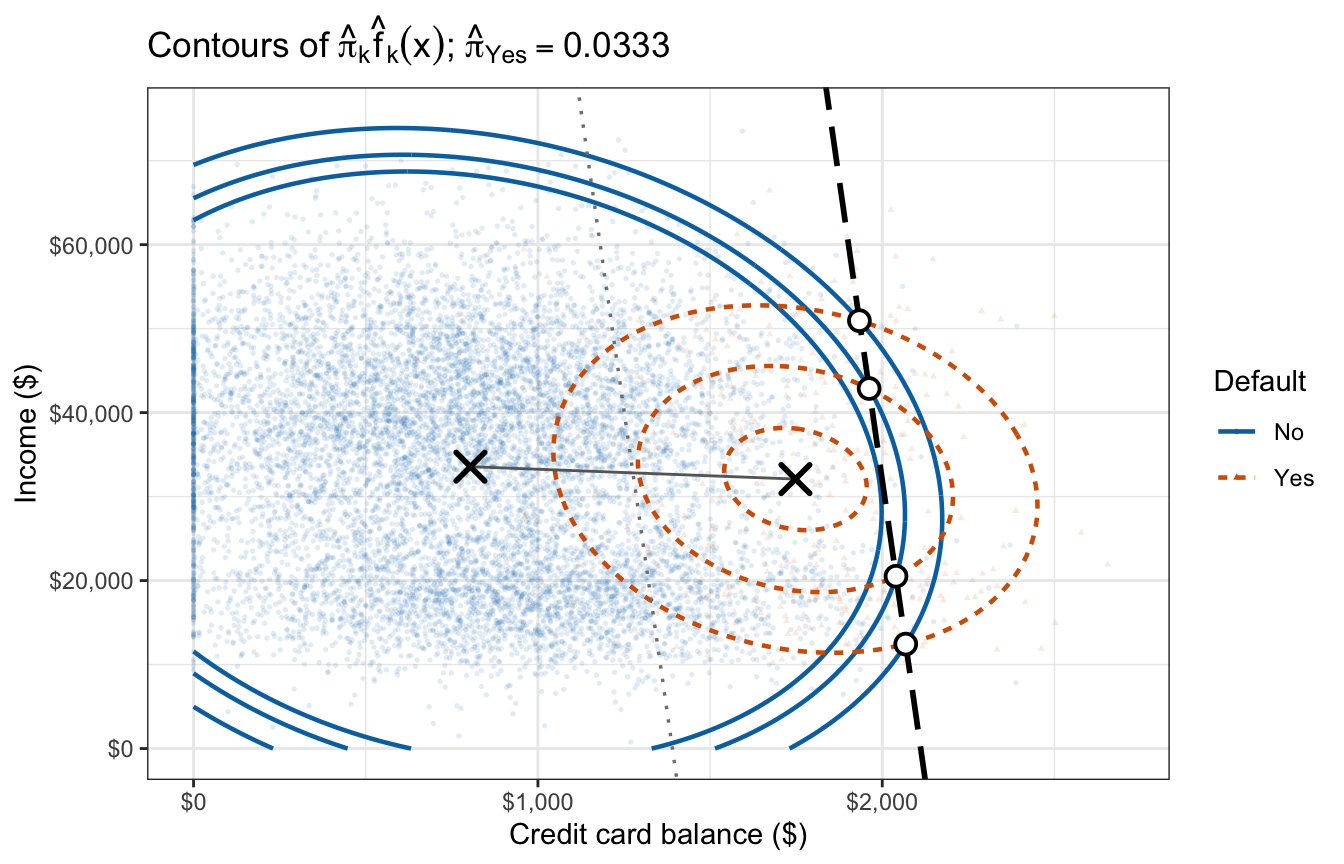
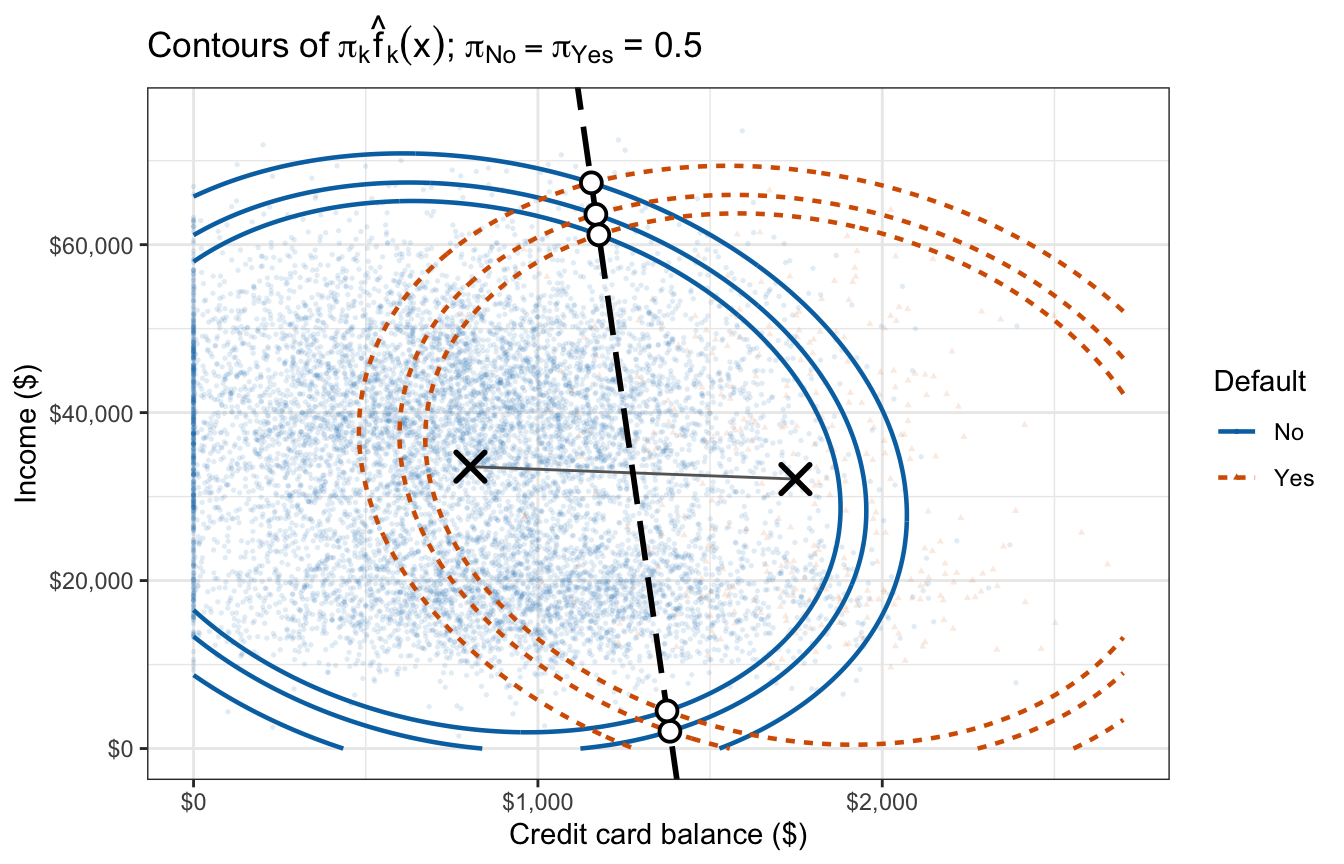
Balance and income

Two continuous features; one contour set per class

Multivariate Gaussian model

\[Y_i \stackrel{ind}{\sim} \text{Categorical}\left(\pi_1, \ldots, \pi_K\right), \qquad X_i \mid Y_i = k \stackrel{ind}{\sim} N_p\left(\mu_k, \Sigma\right), \qquad i = 1, \ldots, n\]

Shared \(\Sigma\)

\[\widehat\mu_k = \frac{1}{n_k}\sum_{i:\, y_i = k} x_i, \qquad \widehat\Sigma = \frac{1}{n - K}\sum_{k=1}^K \sum_{i:\, y_i = k}\left(x_i - \widehat\mu_k\right)\left(x_i - \widehat\mu_k\right)^\top\]

Pooled over classes with divisor \(n - K\)

Matrix-form discriminant

\[\log\left[\pi_k f_k(x)\right] = \log \pi_k - \frac{1}{2}\mu_k^\top \Sigma^{-1} \mu_k + x^\top \Sigma^{-1} \mu_k - \frac{p}{2}\log(2\pi) - \frac{1}{2}\log|\Sigma| - \frac{1}{2}x^\top \Sigma^{-1} x\]

Dropping the terms that do not involve \(k\) gives the discriminant function

\[\delta_k(x) = \left(\log \pi_k - \frac{1}{2}\mu_k^\top \Sigma^{-1} \mu_k\right) + x^\top \Sigma^{-1} \mu_k\]

Linear in \(x\)

Decision boundary \(\delta_1(x) = \delta_2(x)\): a hyperplane, a line when \(p = 2\)

\[\log\left[\frac{p_2(x)}{1 - p_2(x)}\right] = \delta_2(x) - \delta_1(x) = \beta_0 + x^\top\beta\]

Fitted densities and priors

Boundary through the crossings of the prior-weighted contours
Fitting multiple-feature LDA

fit2 <- MASS::lda(
  default ~ balance + income,
  data = Default)

fit2$prior
fit2$means
fit2$scaling

predict(fit2,
        data.frame(balance = 1500,
                   income = 40000)
       )$posterior
> fit2$prior
    No    Yes 
0.9667 0.0333 

> fit2$means
      balance   income
No   803.9438 33566.17
Yes 1747.8217 32089.15

> fit2$scaling
                 LD1
balance 2.230835e-03
income  7.793355e-06

> predict(...)$posterior
         No        Yes
1 0.9006332 0.09936682

Comparison to Logistic Regression

Simple logistic regression comparison
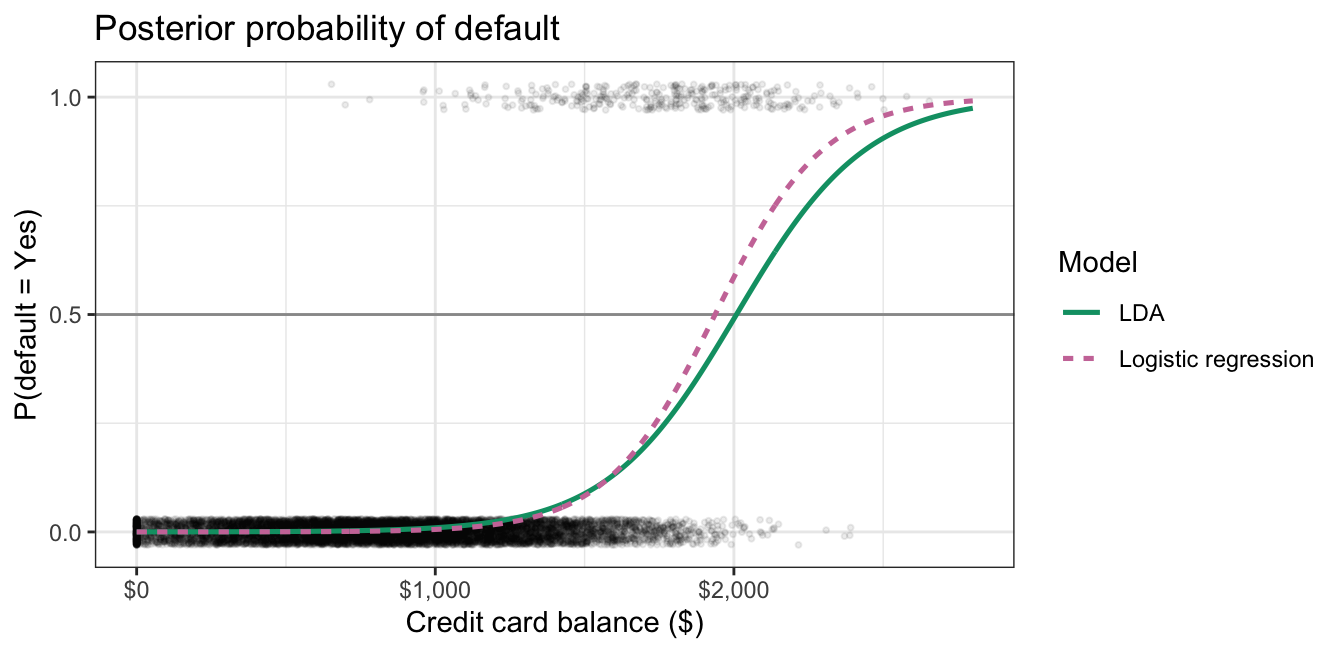
Balance alone: LDA is a logistic curve, slightly flatter than logistic regression

Multiple logistic regression comparison
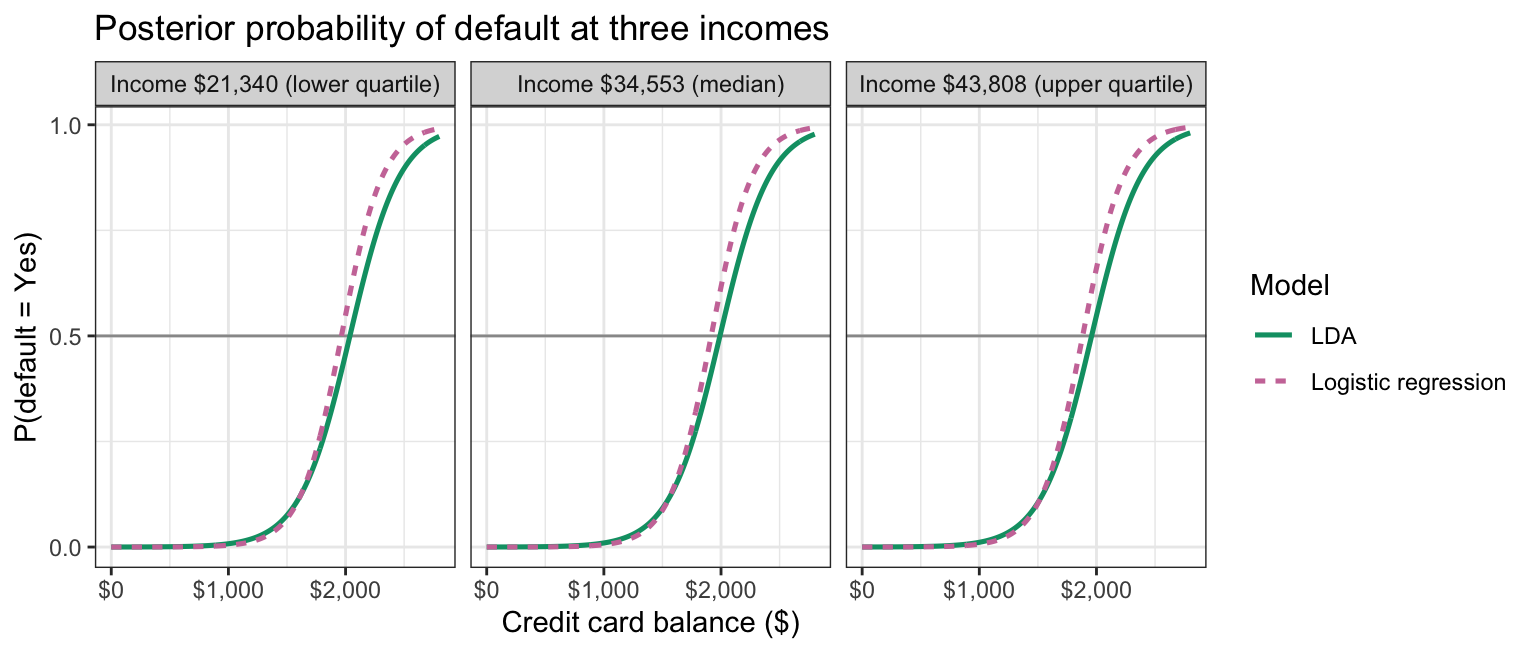
Balance and income: posterior probability by income quartile

Conclusion

  • Bayes’ theorem
  • Generative classifier
  • LDA
  • Discriminant function
  • Linear boundary